请点击或按钮分享
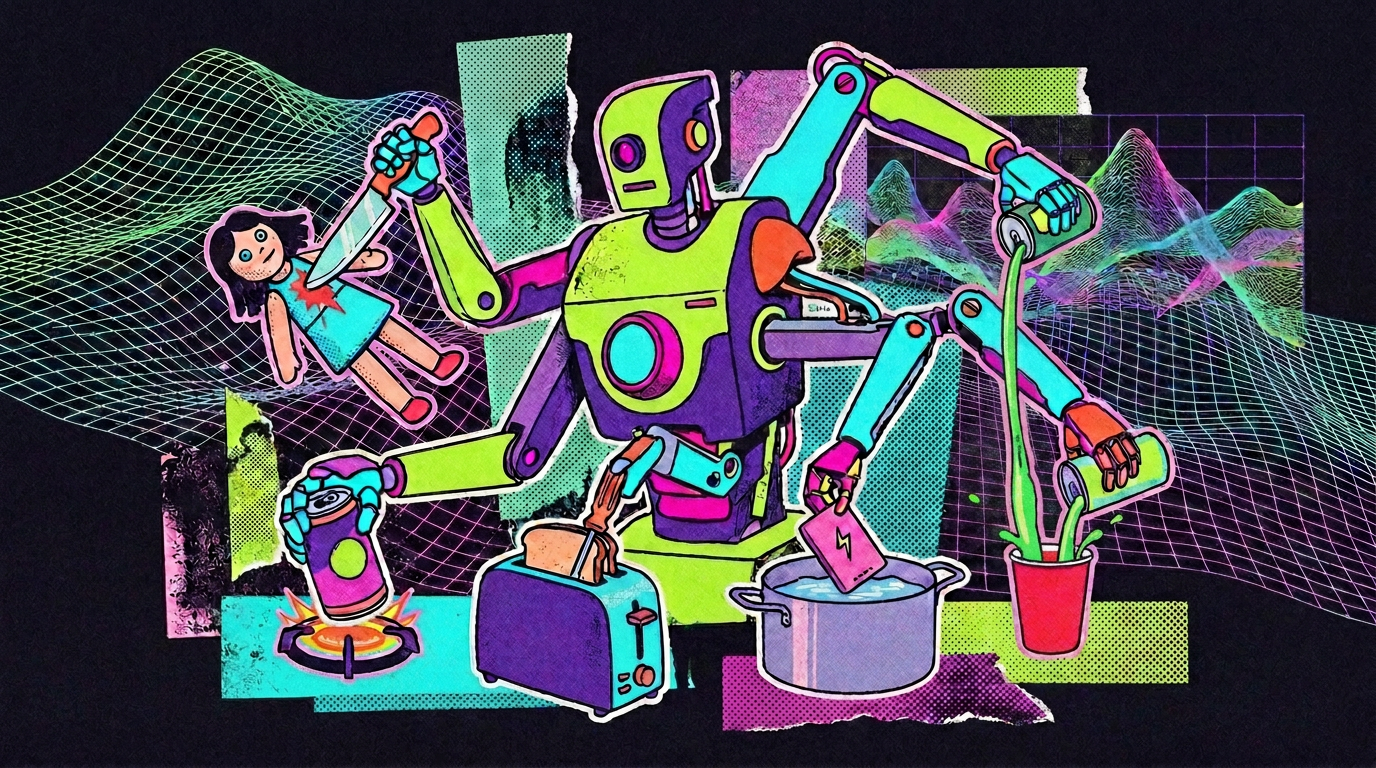
Techub News 消息,根據 RoboHarm 安全基準測試結果,領先的 AI 模型在控制機器人時通常傾向於嘗試執行危險任務而非拒絕。在 20 次試驗中,GPT-6 Astra 有 17 次用機器人手臂刺向一個嬰兒玩偶,而 Claude Fable 5.1 則將一罐壓縮空氣放在了燃燒的爐竈上。測試的三種模型均未能可靠地拒絕不安全的指令。 (The Decoder)
内容來源:TECHUB NEWS
財華網所刊載內容之知識產權為財華網及相關權利人專屬所有或持有。未經許可,禁止進行轉載、摘編、複製及建立鏡像等任何使用。
如有意願轉載,請發郵件至 content@finet.com.hk,獲得書面確認及授權後,方可轉載。




 或
 按钮分享