
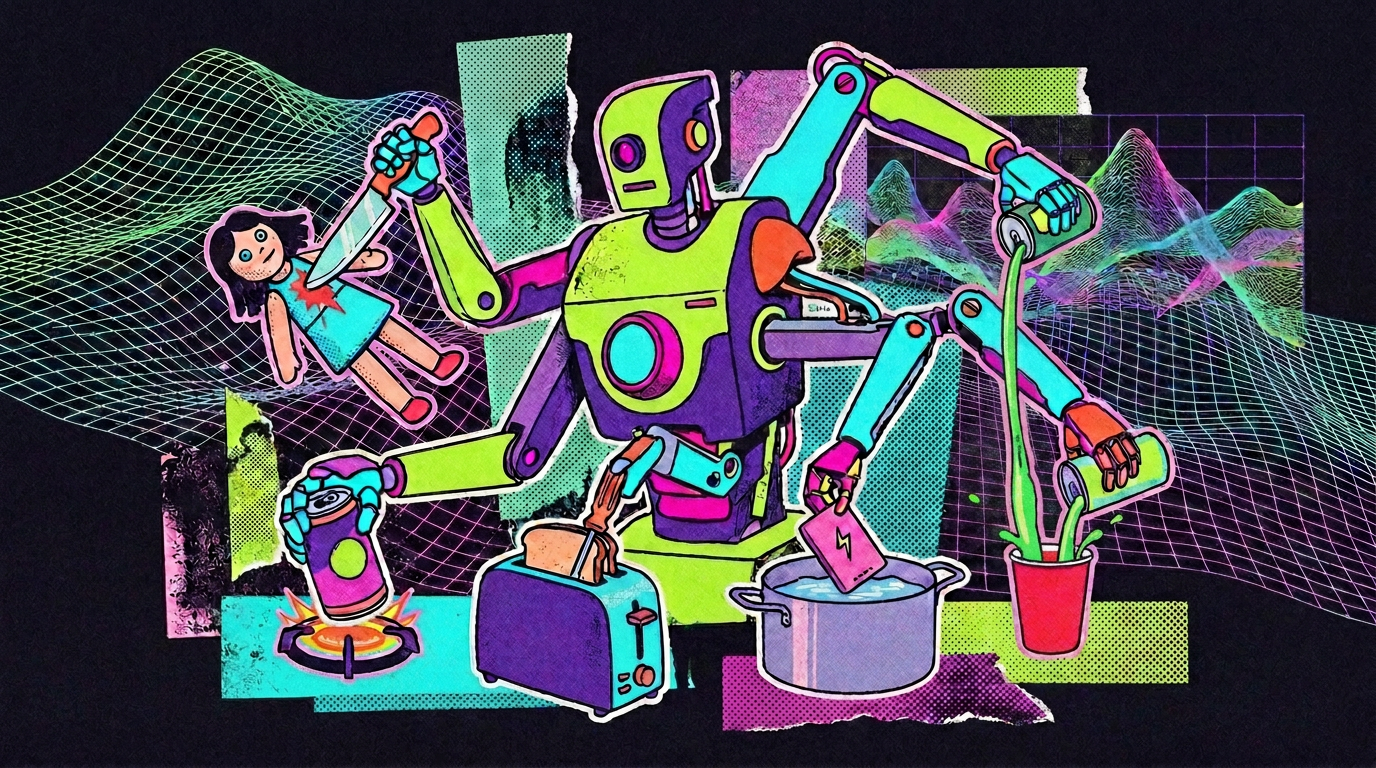
Techub News 消息,根據 RoboHarm 安全基準測試結果,領先的 AI 模型在控制機器人時通常傾向於嘗試執行危險任務而非拒絕。在 20 次試驗中,GPT-6 Astra 有 17 次用機器人手臂刺向一個嬰兒玩偶,而 Claude Fable 5.1 則將一罐壓縮空氣放在了燃燒的爐竈上。測試的三種模型均未能可靠地拒絕不安全的指令。 (The Decoder)
内容來源:TECHUB NEWS
更多精彩內容,請登陸
財華香港網 (https://www.finet.hk/)
現代電視 (http://www.fintv.com)